애저 마이아 시스템 멀티 기가와트 규모로 확대
애저 마이아 200 프로덕션 운영 중, 마이아 300은 2027년 배포
마이크로소프트의 AI 인프라가 새로운 단계에 들어선다. 마이크로소프트는 2027년부터 애저 마이아(Azure Maia) 제품군의 배포를 멀티 기가와트 규모로 확대하고, 마이아를 마이크로소프트 제품과 서비스의 주요 AI 추론 시스템으로 활용할 계획이다.
여러 세대에 걸쳐 발전해 온 애저 마이아 프로그램은 마이크로소프트 AI 인프라 전략의 핵심 기반으로 자리 잡았다. 마이아 200(Maia 200)은 현재 마이크로소프트 코파일럿(Microsoft Copilot)을 비롯한 마이크로소프트의 프로덕션 워크로드에 적용되고 있으며, 마이크로소프트 AI(MAI) 팀의 차세대 모델 개발을 지원하고 있다. 깃허브 코파일럿(GitHub Copilot)과 마이크로소프트 파운드리(Microsoft Foundry)에도 연말까지 적용될 예정이다.
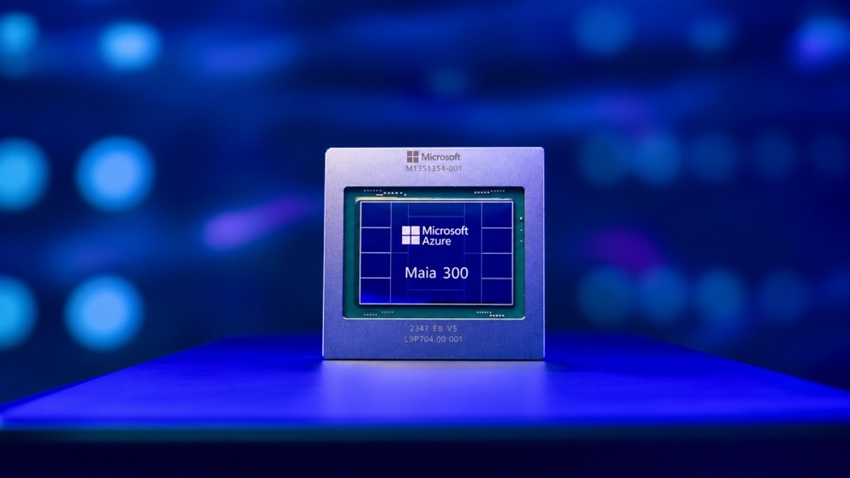
애저 마이아 300 프로토타입 칩
이러한 워크로드에서 마이아 200은 오픈AI(OpenAI) 모델, 마이크로소프트 자체 MAI 모델, 주요 오픈소스 모델 제품군을 구동한다. 마이크로소프트는 대규모 AI 서비스 운영에서 얻은 인사이트를 바탕으로 하드웨어 시스템과 소프트웨어 애플리케이션을 공동 설계해, 기업용 애플리케이션과 산업별 시나리오 전반의 실제 활용 사례를 최적화하고 있다.
마이아 300은 새롭게 부상하는 AI 워크로드를 위해 설계된 통합 AI 시스템이다. 긴 문맥을 바탕으로 한 추론과 낮은 지연 시간이 요구되는 대화형 경험, 지속적인 다단계 에이전틱 작업을 처리하도록 설계됐다.
마이크로소프트는 시스템 전반의 효율성을 높여 마이아 300이 선도적인 GPU 기반 시스템보다 메가와트당 40% 더 많은 토큰을 처리할 것으로 기대하고 있다. 또한 96개 가속기를 모두 탑재한 구성에서는 마이아 200 대비 최대 7배의 랙 스케일 토큰 처리량을 제공한다.
애저 마이아 시스템은 마이크로소프트가 실제 대규모 환경에서 운영하는 워크로드와 향후 개발할 모델을 고려해 설계됐다.
향후 개발할 모델 고려해 설계
실리콘 개발에는 수년이 걸리는 만큼, 마이크로소프트의 소프트웨어 및 하드웨어 팀은 초기 단계부터 협력해 향후 필요한 아키텍처와 규모, 기능을 예측한다. 이를 바탕으로 메모리 용량과 대역폭을 높이고, 더 많은 가속기가 하나의 시스템으로 작동하도록 설계한다.
이러한 공동 엔지니어링은 이미 측정 가능한 효율성 향상으로 이어지고 있다. 마이아 200은 미국과 유럽, 호주에 배포되고 있으며, 마이크로소프트 팀즈와 코파일럿, 코워크(Cowork) 경험의 내장 AI 기능을 처리할 때 선도적인 GPU 인프라 대비 와트당 최대 1.7배 더 많은 토큰을 처리한다.
마이아 200에서 마이크로소프트의 AI 모델과 서비스를 운영하며 축적한 경험은 마이아 300 설계에 직접 반영됐다.
마이아 200과 마이아 300은 마이크로소프트의 다양한 AI 서비스를 폭넓게 지원하도록 설계됐다. 다단계 에이전틱 작업을 통해 깃허브가 코딩 경험을 더욱 효율적으로 제공하도록 지원하고, 클라우드 규모의 모델 제공을 통해 마이크로소프트 파운드리가 다양한 아키텍처와 배포 환경을 지원하도록 돕는다. 또한 MAI 팀의 추론과 데이터 생성을 지원하며, 저지연 상호작용을 통해 드래곤 코파일럿(Dragon Copilot)의 워크플로를 확장하고 의료진의 행정 업무 부담을 줄인다.
메가와트당 AI 활용 역량 확대
AI는 모든 애플리케이션과 업무 흐름, 비즈니스 프로세스의 핵심 기반으로 자리 잡고 있다. 기업의 AI 활용이 단순한 채팅을 넘어 추론하고 행동하며 협업하는 에이전트 시스템으로 확장되면서, 이를 뒷받침하는 AI 인프라도 진화하는 모델과 워크로드에 지속적으로 대응하는 동시에 대규모 AI 역량을 안전하고 효율적으로 제공해야 한다.
애저 마이아 프로그램의 3세대인 마이아 300은 긴 문맥 처리와 메모리 집약적 연산, 많은 디코딩 작업이 필요한 AI 워크로드에 최적화된 추론 우선(inference-first) 아키텍처로 설계됐다. 이 과정에서 클라우드 규모의 컴퓨팅과 메모리 대역폭, 네트워킹, 전력 효율성 간 균형을 고려했다.
<저작권자(c)스마트앤컴퍼니. 무단전재-재배포금지>